Los investigadores han constatado la aparición de una nueva forma de desigualdad digital. Si hace veinte años el concepto aludía al acceso limitado a internet, con la llegada de la IA se ha comprobado que el coste de procesar consultas difiere varias veces entre los idiomas más y menos extendidos. Esto limita a los hablantes de lenguas poco comunes y los hace más vulnerables.
Fuente de la imagen: generación con IA de ChatGPT/3DNews
Los investigadores consideran la diferencia de coste de la tokenización entre idiomas muy y poco extendidos como una desigualdad oculta: procesar un mismo texto por su significado en distintos idiomas exige cantidades de tokens sustancialmente distintas. La Coalición por la Igualdad Lingüística en la Investigación en IA (CLEAR) ha dado a conocer el problema. Sus autores lo han bautizado como «impuesto del tokenizador» (tokenizer tax).
Los tokens son fragmentos de texto, audio o vídeo en los que un algoritmo específico, el tokenizador, divide los datos de entrada antes de que los procese un modelo lingüístico. Como muchos servicios comerciales de IA calculan el coste de uso de sus modelos por la cantidad de tokens, dividir el texto en más fragmentos encarece el gasto de los usuarios que trabajan en idiomas distintos del inglés.
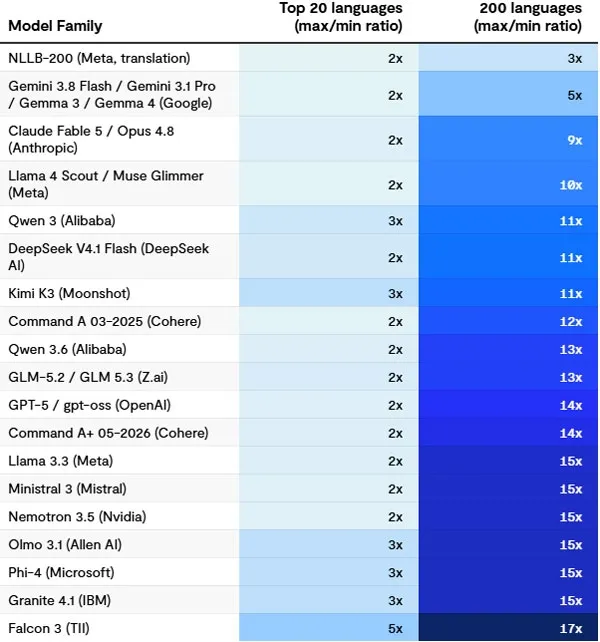
Los investigadores compararon el procesamiento de consultas en distintos idiomas con el corpus de textos FLORES-200, que contiene traducciones paralelas de frases a unos 200 idiomas. Según los resultados publicados, entre los 20 idiomas más extendidos en internet la diferencia en el número de tokens entre las variantes de consulta más y menos costosas iba de 1,5 a 5 veces según el modelo.
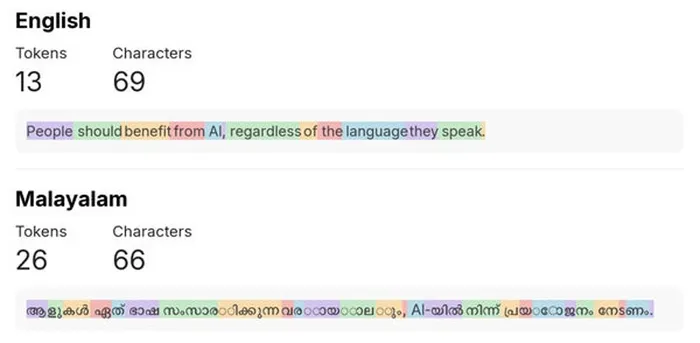
Al ampliar la muestra a 200 idiomas, la brecha llegaba a 17 veces en algunos modelos. Por ejemplo, un texto en malayalam (una de las lenguas del sur de la India) puede dividirse en más fragmentos que el texto equivalente en inglés. En el ejemplo que figura a continuación, una misma frase en inglés y en malayalam requiere 13 y 26 tokens, respectivamente. Conviene tener en cuenta que no existe una proporción estricta entre el coste de procesar consultas en distintos idiomas: todo depende del texto y del contexto, aunque el inglés, obviamente, llevará ventaja en la mayoría de los casos.
Además de la diferencia de coste de procesamiento, hay otra limitación relacionada con la reducción del espacio de contexto disponible. Puede ser incluso más importante, ya que se observa una clara tendencia a la bajada del precio de los tokens. Con un mismo límite de tokens para el contexto, un idioma más costoso deja menos espacio para documentos, mensajes anteriores, historial de interacción y otros datos.
Por último, los tokens adicionales pueden aumentar la carga computacional y la latencia de la respuesta. Los problemas más acusados se han detectado en idiomas que emplean escrituras insuficientemente representadas en los datos de entrenamiento de los tokenizadores. Entre ellos, los investigadores destacan el birmano, el tibetano, el jemer y el laosiano, así como las lenguas que usan las escrituras tifinag y ol chiki. Ahora bien, la rareza de un idioma no determina por sí sola el resultado: el asturiano, por ejemplo, puede salir beneficiado por el alfabeto latino y su parecido con otras lenguas romances.
Como posibles vías para reducir la brecha, los especialistas proponen ampliar la presencia de datos multilingües de calidad en los conjuntos de entrenamiento y desarrollar tokenizadores específicos para distintas escrituras. Sin embargo, aumentar la cantidad de datos no garantiza por sí solo resolver el problema: también hay que perfeccionar los algoritmos de división del texto. Conviene recordar que nada ocurre por sí solo y que los desarrolladores de modelos de IA deben asumir la idea de reducir la desigualdad digital en el ámbito de la inteligencia artificial.