La empresa con sede en Redwood City (EE. UU.) ha presentado Mercury 3, un gran modelo de lenguaje de difusión (dLLM) que es 40 veces mayor que su predecesor, Mercury 1, pero mantiene una alta velocidad de funcionamiento: más de 1000 tokens por segundo. En varias pruebas, Mercury 3 supera a GPT-6 Luna y a Claude Haiku 5.5, y lo hace funcionando mucho más rápido.
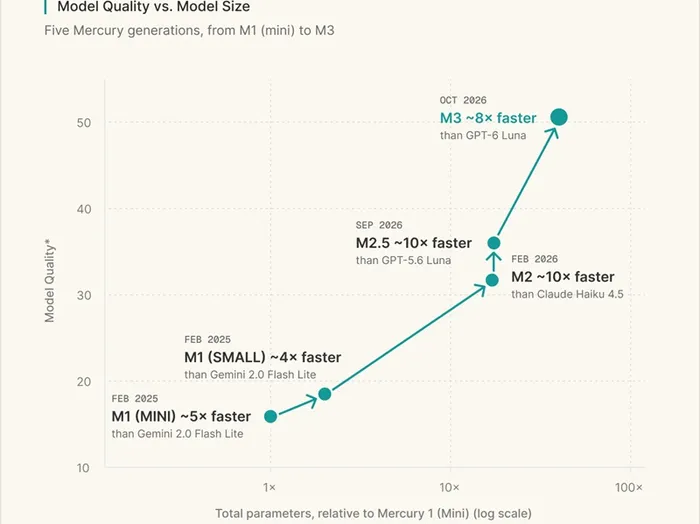
Fuente de la imagen: Inception
A diferencia de los grandes modelos de lenguaje (LLM), que generan texto token a token, los modelos de difusión pueden emitir varios tokens a la vez, lo que se traduce en una ventaja de velocidad.
Antes, los desarrolladores tenían que elegir entre modelos compactos y rápidos (para tareas sensibles a la latencia) o alternativas más potentes pero lentas. Según Inception, Mercury 3 reúne ambas cualidades. Es bastante más grande y funcional que sus predecesores, pero sigue funcionando a más de 1000 tokens por segundo. Además, su ventana de contexto —la cantidad de texto que el modelo puede procesar de una vez— ha aumentado hasta 1 millón de tokens (en la versión anterior, Mercury 2.5, era de 260.000).
Según las pruebas internas de la compañía, Mercury 3 supera a GPT-6 Luna de OpenAI, Claude Haiku 5.5 de Anthropic y GLM-5.3 Flash de Zhipu en varios indicadores, y lo hace funcionando entre 4 y 8 veces más rápido. «Las respuestas de estos modelos llegan prácticamente al instante», ha afirmado el consejero delegado de Inception, Stefano Ermon.
Mercury 3 es el cuarto modelo que Inception lanza desde la aparición de Mercury 1 en junio de 2025. Con cada nueva versión han crecido sus funciones sin afectar a la velocidad. Así, Mercury 2 incorporó mecanismos de razonamiento lógico y Mercury 2.5 permitió configurarlos y amplió la ventana de contexto a 260.000 tokens. Según el desarrollador, Mercury 3 supone el mayor salto cualitativo en la evolución de la familia.
Mercury 3 está disponible a través de Inception API, Baseten, OpenRouter y Vercel. Gracias a su compatibilidad con la API de OpenAI, los desarrolladores pueden pasarse a él sin necesidad de reescribir el código.
El uso de Mercury 3 cuesta 0,2 dólares por millón de tokens de entrada y 0,7 dólares por millón de tokens de salida. En la fase de lanzamiento, la compañía ha reducido las tarifas a la mitad: 0,1 y 0,35 dólares, respectivamente.