Meta ha lanzado dos nuevos modelos de IA, Muse Wonder y Muse Wonder Full, que se posicionan como rivales directos de los mejores modelos de OpenAI y Anthropic. El acceso a las novedades ya está abierto para los suscriptores del servicio Muse Code, y el modelo Wonder también está disponible a través de Meta Model API.
Fuente de la imagen: Meta
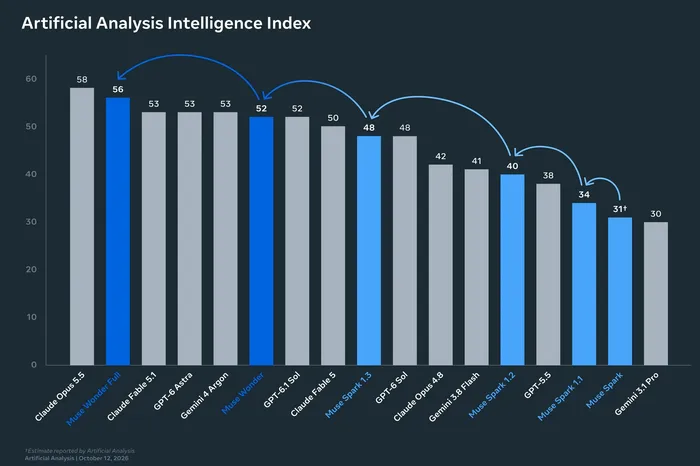
Los desarrolladores afirman que las nuevas IA no van a la zaga en capacidades a GPT-6 Astra, Claude Opus 5.5 y Claude Fable 5.1. Estas afirmaciones se basan en los resultados de pruebas internas en referencias del sector. Sin embargo, la comparación con Gemini 4 Argon de Google sigue siendo ambigua, ya que el mercado aún no ha estudiado por completo las capacidades del modelo. En la mayoría de las comparaciones se utilizó el nivel máximo de razonamiento de los modelos.
En el índice compuesto Personal Superintelligence Index, que reúne siete pruebas de realización de tareas profesionales y cotidianas, Muse Wonder Full obtuvo 59,1 puntos. A modo de comparación, el resultado de GPT-6 Astra fue de 54,5 puntos, el de Claude Opus 5.5 de 55,2 y el de Claude Fable 5.1 de 49,9. La versión estándar de Muse Wonder logró 54,3 puntos.
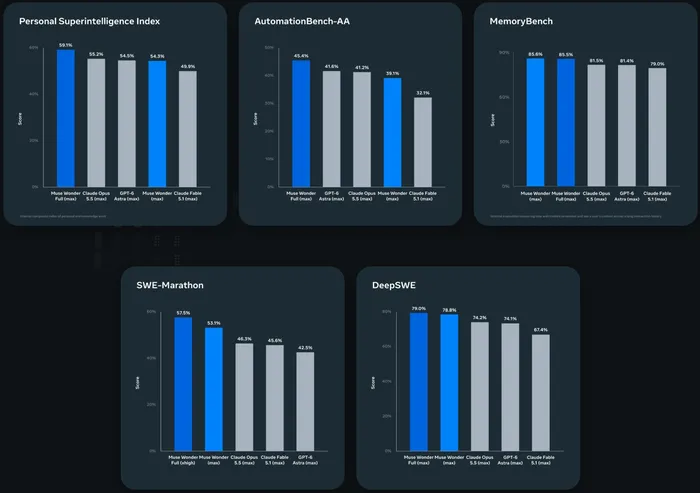
La diferencia más notable frente a los competidores se registró en tareas de programación. En DeepSWE 1.1, que evalúa la capacidad de la IA para resolver problemas complejos de desarrollo de software en repositorios existentes, Muse Wonder Full obtuvo 79 puntos frente a los 74,1 de GPT-6 Astra y los 74,2 de Claude Opus 5.5. En la prueba SWE-Marathon, diseñada para el trabajo prolongado en grandes proyectos de software, el resultado del modelo superior alcanzó los 57,5 puntos. Es una cifra muy superior a los 42,5 puntos de GPT-6 Astra, los 45,6 de Claude Fable 5.1 y los 46,3 de Claude Opus 5.5.
Sin embargo, en otras pruebas la ventaja de Muse Wonder resultó menos pronunciada. En Terminal-Bench 4.0, que verifica la ejecución de tareas en la línea de comandos, Muse Wonder Full obtuvo 57,1 puntos, mientras que GPT-6 Astra y Claude Opus 5.5 lograron 59,1 y 59,6 puntos respectivamente. En ProgramBench, que evalúa la capacidad de reconstruir un programa por cuenta propia y superar las comprobaciones automáticas, el resultado del modelo de Meta fue de 59 puntos, frente a los 70,5 de Claude Opus 5.5.
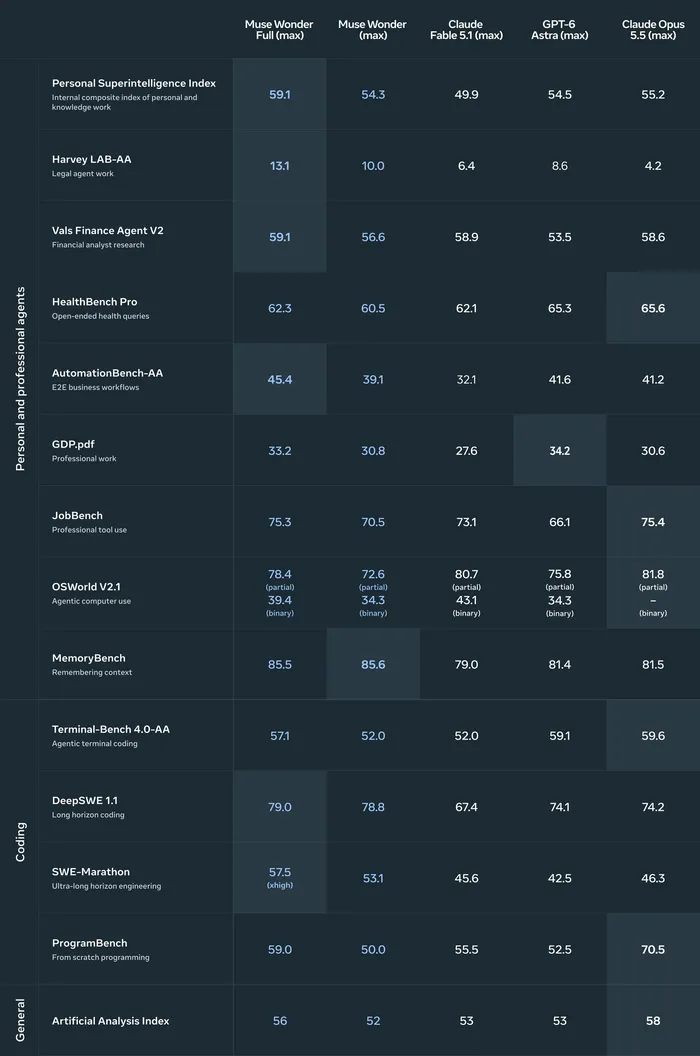
En la prueba Harvey LAB-AA, dedicada a la realización de tareas jurídicas a partir de documentos originales e instrucciones detalladas, Muse Wonder Full volvió a superar con claridad a sus competidores: 13,1 puntos frente a los 8,6 de GPT-6 Astra, los 6,4 de Claude Fable 5.1 y los 4,2 de Claude Opus 5.5.
A medio plazo, Meta planea utilizar la arquitectura Wonder como base para su agente de IA Muse. En primer lugar, los suscriptores de pago tendrán acceso al agente actualizado; después, la compañía tiene previsto desarrollar versiones especializadas para el público general. Por ahora no se revelan los plazos concretos de implantación ni los detalles técnicos.
El lanzamiento de los nuevos modelos forma parte de la agresiva estrategia de Meta para recuperar influencia en el ámbito de la IA. La corporación ha invertido miles de millones de dólares en atraer talento y desarrollar infraestructura, al tiempo que ampliaba su catálogo de productos, incluido el modelo de generación de imágenes Muse Image.