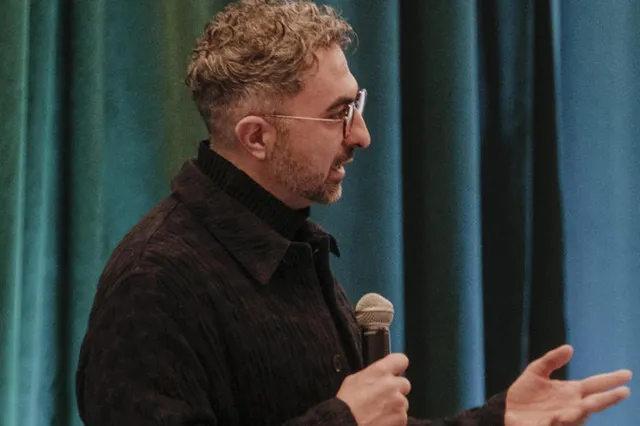
Microsoft ha asegurado que ha creado un modelo de IA más potente que GPT-5.6 con cuatro veces menos recursos de cómputo para entrenarlo que OpenAI. Según Mustafa Suleyman, responsable del área de IA, el nuevo MAI-Base-2 también resulta 12 veces más económico que los modelos de DeepSeek, aunque no concretó con qué sistemas lo compara.
Fuente de la imagen: microsoft.ai
«Ahora tenemos un modelo base preentrenado más potente que el que sustenta GPT-5.6, y para entrenarlo solo hemos utilizado una cuarta parte de los recursos de cómputo que necesitó OpenAI», declaró Suleyman en una reunión general con los empleados. El preentrenamiento es la fase inicial del desarrollo de un modelo de IA, en la que este detecta patrones en grandes conjuntos de texto, imágenes y otros datos. Es un proceso que exige recursos de cómputo colosales y costosos. Si Microsoft ha logrado hacerlo más eficiente, podrá reducir sus gastos de forma notable.
El nuevo modelo de vanguardia se llama MAI-Base-2 y se probó frente a modelos de OpenAI, incluido un sistema con el nombre en clave Spud, sobre el que funciona GPT-5.6. Según Suleyman, el modelo de Microsoft obtuvo mejores resultados en las pruebas que evalúan la capacidad de la IA para comprender y predecir patrones en los datos. Las comparaciones se basan en información técnica sobre los modelos de OpenAI a la que tiene acceso Microsoft. Llama la atención que haya decidido poner el foco en las carencias de los modelos de OpenAI, empresa en la que la corporación ha invertido miles de millones de dólares; su participación en la desarrolladora de ChatGPT probablemente supere los 100.000 millones de dólares. Las críticas a OpenAI podrían perjudicar el valor de esa inversión.
A ambas las une una estrecha colaboración: Microsoft da a los clientes de su plataforma en la nube Azure acceso a los modelos de OpenAI y utiliza estos modelos en productos propios como Copilot. En el último año, la relación entre las dos compañías se ha enfriado notablemente: Microsoft busca cada vez más actuar al margen de OpenAI, incluso desarrollando modelos propios. Según Mustafa Suleyman, el nuevo modelo de Microsoft también demuestra una mayor eficiencia computacional: consume 12 veces menos recursos que DeepSeek. No precisó a qué modelo del laboratorio chino se refiere, pero en el blog de la compañía se afirma que el preentrenamiento de MAI-Base-2 resultó mucho más eficiente que los valores equivalentes de DeepSeek-V4-Pro-Base.
En marzo, Microsoft formó un equipo unificado para trabajar en las versiones comerciales y de consumo de Copilot, y Suleyman pasó a dirigir el área de desarrollo de IA.